
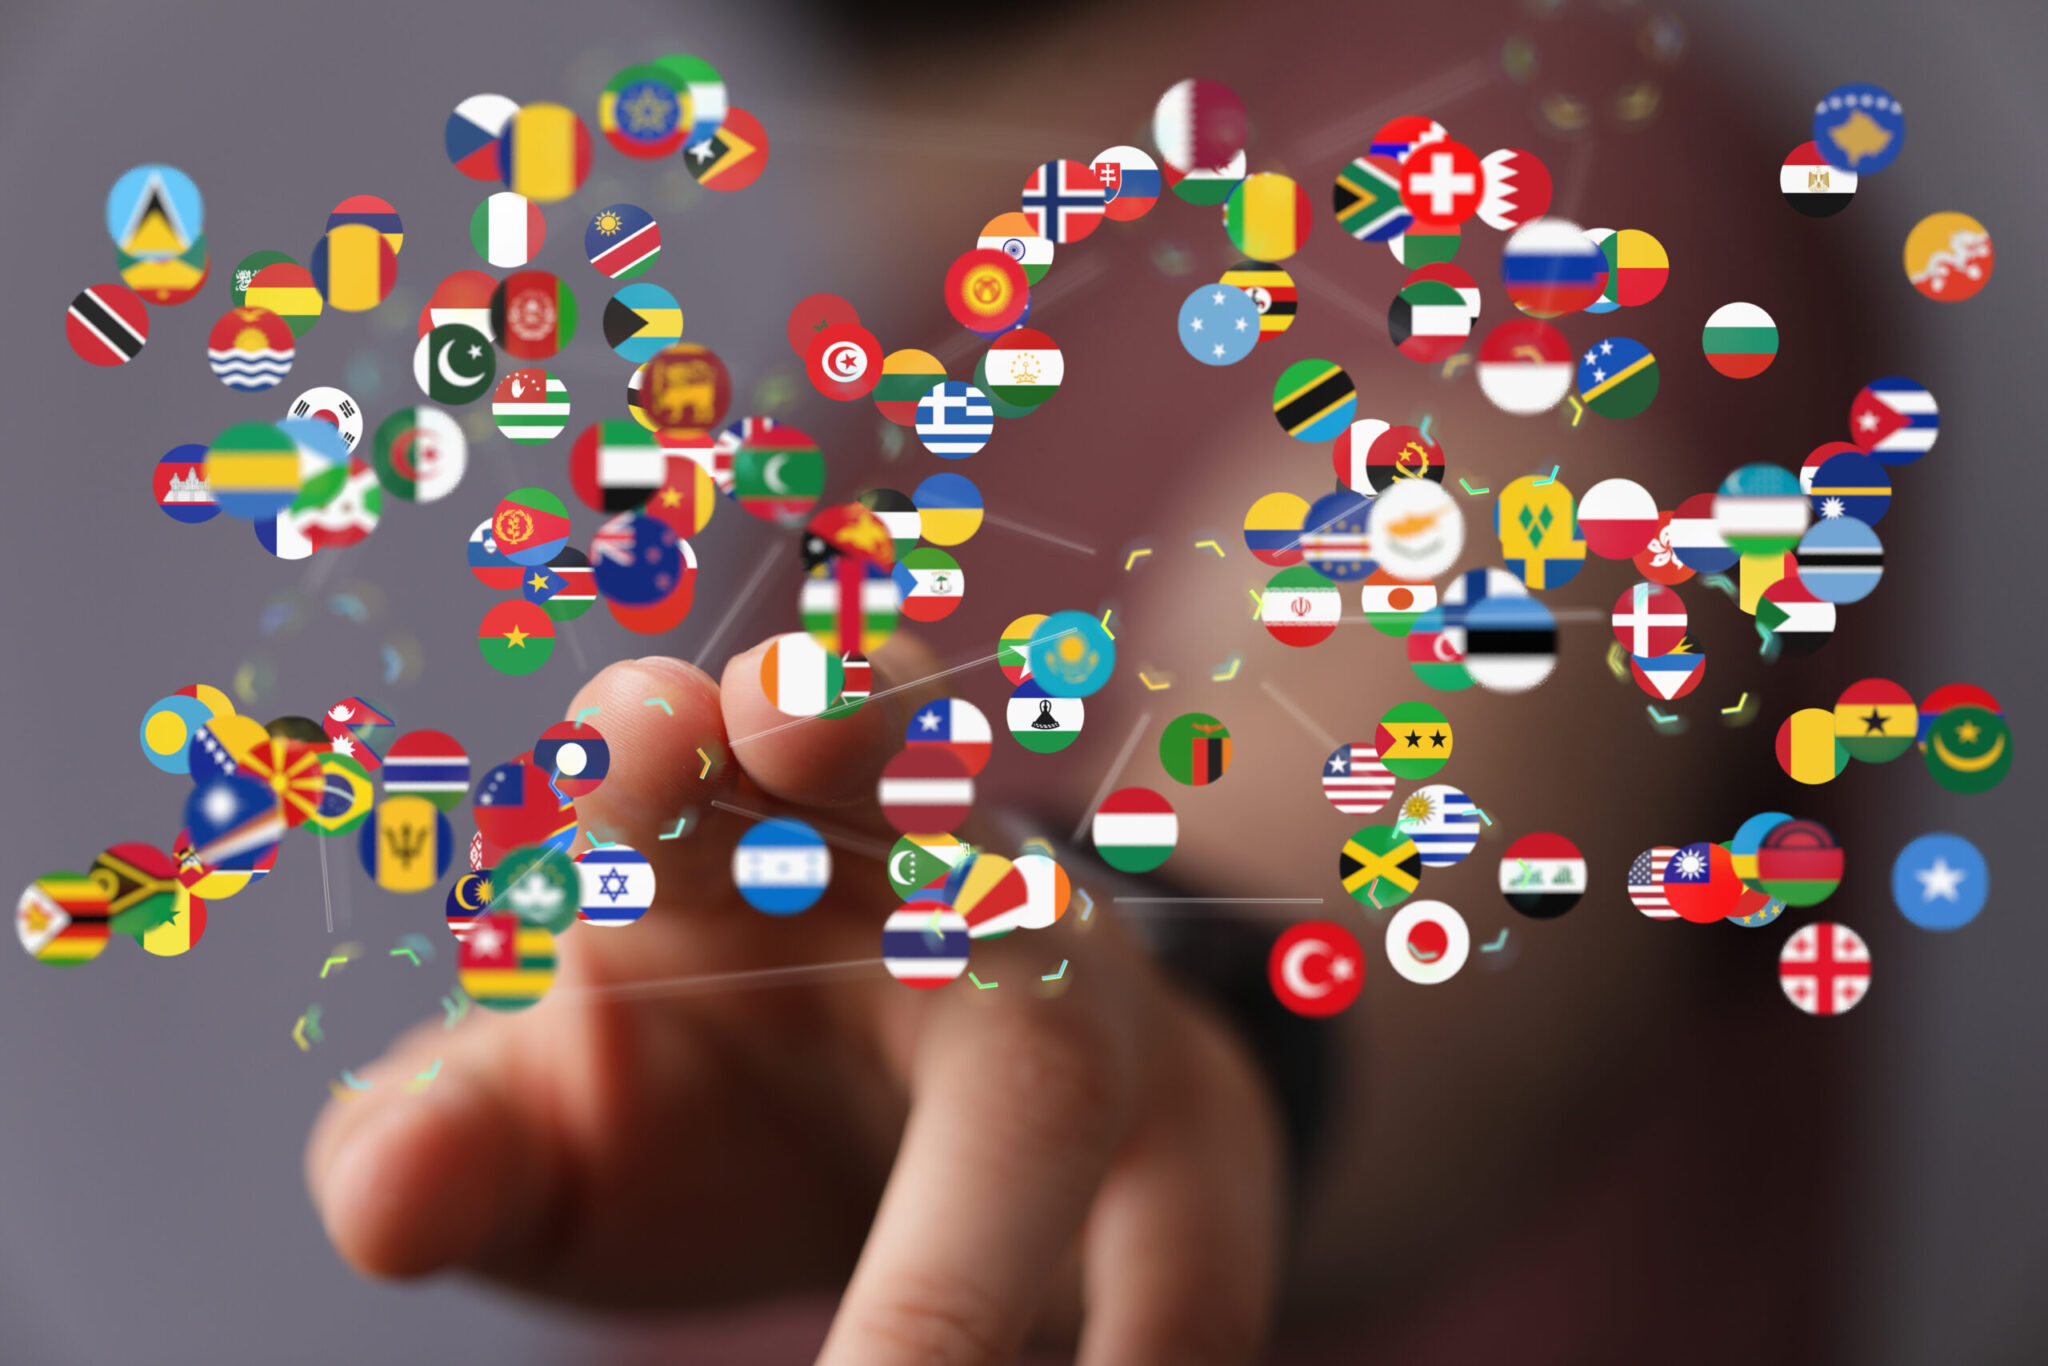



Όλο και περισσότερο αυξάνονται οι ανησυχίες σχετικά με το ψηφιακό και γλωσσικό χάσμα που φαίνεται να δημιουργούν τα μοντέλα τεχνητής νοημοσήνης, καθώς σύμφωνα με ερευνητές ειναι ιδιαίτερο προβληματικό το γεγονός ότι τα ψηφιακά εργαλεία δεν λειτουργούν το ίδιο αποτελεσματικά για τα περίπου 5 δισεκατομμύρια ανθρώπους που δεν μιλούν αγγλικά.
Συγκεκριμένα, το ChatGPT και το Gemini λειτουργούν αποτελεσματικά για τα 1,52 δισεκατομμύρια ανθρώπους που μιλούν αγγλικά, ωστόσο παρουσιάζουν χαμηλότερες επιδόσεις για τους 97 εκατομμύρια ομιλητές της βιετναμέζικης γλώσσας και ακόμη χειρότερες για τα 1,5 εκατομμύρια ανθρώπους που μιλούν τη ναουάτλ, μια γλώσσα της οικογένειας των ουτο-αζτεκικών γλωσσών.
Και αυτό γιατί συμβαίνει; Για τις παραπάνω γλώσσες και για κάποιες ακόμη δεν υπάρχουν αρκετά δεδομένα, ώστε να εκπαιδευθούν αποτελεσματικά τα μοντέλα AI. Τα τελευταία εκπαιδεύονται κυρίως στην αγγλική ή σε άλλες κύριες γλώσσες με αποτέλεσμα να μην είναι προσαρμοσμένα και εξοικειωμένα με άλλες τοπικές γλώσσες και διαλέκτους.
Ολόκληροι λαοί και πολιτισμοί αποκλείονται από την επανάσταση της τεχνητής νοημοσύνης
Κοινωνικές και οικονομικές ανισότητες
Οι επιπτώσεις αυτού του ψηφιακού χάσματος δεν αφορούν τόσο τη δυσκολία στην καθημερινή χρήση των εργαλείων AI, αλλά κυρίως στη επέκταση του αποκλεισμού. Ολόκληροι λαοί και πολιτισμοί αποκλείονται από την επανάσταση της τεχνητής νοημοσύνης, μένουν ανενημέρωτοι και ως αποτέλεσμα δέχονται αβίαστα παραπληροφόρηση και προκαταλήψεις. Παράλληλα, χάνουν εργασιακές, οικονομικές και εκπαιδευτικές ευκαιρίες, που «καρπώνονται» οι ευνοιμένοι λαοί που μιλούν αγγλικά.
Στη συνέντευξη, ο Σάνμι Κογιέτζο, αναπληρωτής καθηγητής στη Σχολή Μηχανικών του Πανεπιστημίου Στάνφορντ και βασικός συντάκτης μίας νέας έκθεσης για το ζήτημα, εξηγεί τους κινδύνους που συνεπάγεται το γλωσσικό χάσμα στην τεχνητή νοημοσύνη, εστιάζοντας παράλληλα στα μέτρα που μπορούν να λάβουν οι δημιουργοί των μοντέλων για να αντιμετωπίσουν το πρόβλημα.
Όπως αναφέρει, ανάμεσα στις γλώσσες με περιορισμένους πόρους είναι και η σουαχίλι, την οποία μιλούν περίπου 200 εκατομμύρια άνθρωποι, αλλά για την οποία δεν υπάρχουν επαρκείς ψηφιακοί πόροι για την εκπαίδευση μοντέλων τεχνητής νοημοσύνης. Αντίθετα, τα ουαλικά, αν και έχουν λιγότερους ομιλητές, διαθέτουν εκτενέστερη γλωσσική τεκμηρίωση και έχουν ωφεληθεί από πρωτοβουλίες ψηφιακής διατήρησης.
Υγεία και εργασία: Στη σκιά της τεχνητής νοημοσύνης
Ένας τομέας στον οποίο η τεχνητή νοημοσύνη θα μπορούσε να προσφέρει σημαντική βοήθεια είναι η υγεία. Τα σχετικά μοντέλα έχουν τη δυνατότητα να απαντούν σε ερωτήματα για τη διάγνωση ασθενειών και να υποστηρίζουν τη λήψη κλινικών αποφάσεων. Εκτιμάται, μάλιστα, ότι η αξιοποίησή τους θα μπορούσε να βελτιώσει τη δημόσια υγεία, να ενισχύσει την ποιότητα ζωής σε βάθος χρόνου και να δημιουργήσει οικονομικά οφέλη για μεγάλες πληθυσμιακές ομάδες.
Ιδιαίτερες ανησυχίες προκαλούνται και για την αγορά εργασίας. Καθώς η τεχνητή νοημοσύνη αλλάζει σταδιακά τον τρόπο με τον οποίο εργάζονται οι άνθρωποι, όσοι διαθέτουν καλή γνώση αγγλικών ενδέχεται να αποκτήσουν σημαντικό πλεονέκτημα. Αντίθετα, οι εργαζόμενοι που δεν έχουν αντίστοιχες γλωσσικές δεξιότητες μπορεί να δυσκολεύονται περισσότερο να αξιοποιήσουν τα νέα τεχνολογικά εργαλεία και να αποκτήσουν πρόσβαση σε επαγγελματικές ευκαιρίες, γεγονός που ενδέχεται να ενισχύσει τις υφιστάμενες οικονομικές ανισότητες.
Οι λύσεις για την ενίσχυση των γλωσσών με περιορισμένους πόρους
Οι λύσεις που εξετάζονται για τη βελτίωση των γλωσσικών μοντέλων σε γλώσσες με περιορισμένους γλωσσικούς πόρους περιλαμβάνουν την ανάπτυξη μεγάλων μοντέλων που υποστηρίζουν πολλές γλώσσες, μικρότερων που εξειδικεύονται σε μία γλώσσα, αλλά και μοντέλων μεσαίου μεγέθους που καλύπτουν γλωσσικές ομάδες με κοινά χαρακτηριστικά.
Μια ακόμη προσέγγιση είναι η αξιοποίηση της αυτόματης μετάφρασης για τη δημιουργία περισσότερων δεδομένων εκπαίδευσης. Ωστόσο, η μέθοδος αυτή συχνά δεν αποδίδει τις πολιτισμικές ιδιαιτερότητες και τις φυσικές εκφράσεις κάθε γλώσσας. Για τον λόγο αυτό, προτείνεται και η συλλογή γλωσσικού υλικού απευθείας από τις τοπικές κοινότητες, με παράλληλη διασφάλιση των δικαιωμάτων τους στα δεδομένα.
Ο κίνδυνος απώλειας της πολιτισμικής πολυμορφίας από την τεχνητή νοημοσύνη
Κίνδυνος η γλωσσική και πολιτισμική πολυμορφία να περιοριστεί σε ένα ενιαίο αμερικανοκεντρικό πρότυπο
Μία ακόμη ανησυχία σχετικά με την εξάπλωση της τεχνητής νοημοσύνης είναι ότι τα μεγάλα γλωσσικά μοντέλα δεν αποτυπώνουν πάντα με ακρίβεια τις πολιτισμικές αξίες και τις ιδιαιτερότητες κάθε κοινότητας. Συχνά εκπαιδεύονται σε επίσημα κείμενα, όπως κοινοβουλευτικές ομιλίες, με αποτέλεσμα να μην αναγνωρίζουν τον καθημερινό τρόπο ομιλίας.
Έρευνες έχουν δείξει, επίσης, ότι τα μοντέλα ενδέχεται να υιοθετούν πολιτικές αντιλήψεις που συνδέονται με το περιβάλλον στο οποίο αναπτύχθηκαν, ενώ παρουσιάζουν αδυναμίες στην κατανόηση διαφορετικών γλωσσικών διαλέκτων, όπως η αφροαμερικανική αγγλική.
Ο κίνδυνος, σύμφωνα με τους ερευνητές, είναι η γλωσσική και πολιτισμική πολυμορφία να περιοριστεί σε ένα ενιαίο, κυρίως αμερικανοκεντρικό πρότυπο. Για την αποφυγή αυτού του φαινομένου, προτείνονται επενδύσεις, συμμετοχή των τοπικών κοινοτήτων στην έρευνα και δίκαιοι κανόνες για την ιδιοκτησία και χρήση των γλωσσικών δεδομένων.
Με πληροφορίες από: stanford.edu